Smart Manufacturing in Europa ist längst über PLCs plus Dashboards hinausgegangen. Heute umfasst es Computer-Vision-Inspektion, KI-gesteuerte Optimierung, digitale Zwillinge, die Live-Treue erfordern, und Edge-Cluster, die sich wie Mini-Rechenzentren verhalten müssen – zuverlässig, jeden Tag.
In dieser Realität ist der häufigste Skalierungsschmerz oft nicht das Modell oder die GPU. Es ist das Netzwerk: Überlastung, Jitter und Paketverluste treten genau dann auf, wenn Sie die nächste Linie, den nächsten Satz Kameras oder die nächste Analyse-Pipeline hinzufügen.
Why factory AI stresses networks differently
Industrielle Datenmuster können etwas... unhöflich sein. Man sieht oft:
- High-rate vision streams feeding inference nodes and storage simultaneously
- Burstige “Incast”-Momente, wenn viele Geräte gleichzeitig melden (Alarme, Batch-Ereignisse, Statistiken zum Zyklusende)
- Ost-West-Verkehr zwischen Knoten für Analytik, Feature-Extraktion und Simulation
- Eine Mischung aus harten Echtzeit-ähnlichen Datenströmen (Inspektions-Gating, Roboterkoordination) neben weniger kritischem Datenverkehr
In Best-Effort-Netzwerken können Mikrobursts und Warteschlangendruck zu Paketverlusten und erneuten Übertragungen führen – ein häufiger Weg zu Tail-Latency-Spitzen. (Deshalb stützen sich „verlustfreie Ethernet“-Designs für RDMA typischerweise auf Mechanismen wie PFC und ECN/DCQCN, mit sorgfältiger Abstimmung über den gesamten Pfad.)
CN5000s verlustfreies, staufreies Scale-out-Fabric
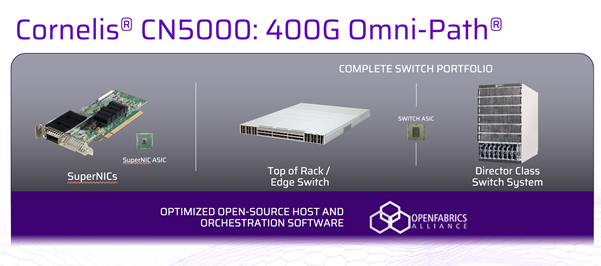
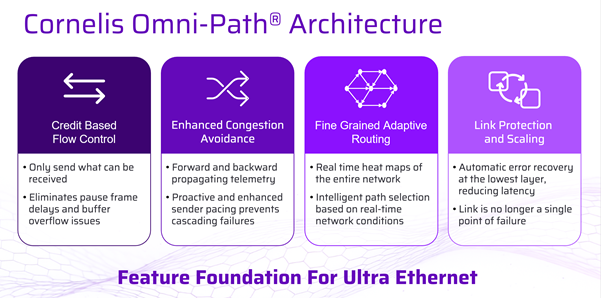
Cornelis beschreibt CN5000 als Lieferant verlustfreier, überlastungsfreier Datenübertragung unter Verwendung von kreditbasierter Flusskontrolle und dynamischem, feinkörnigem adaptivem Routing, das darauf ausgelegt ist, Durchsatz und Latenz bei steigender Last vorhersehbar zu halten.
Eine nützliche Möglichkeit, es für Hersteller zu formulieren:
Der CN5000 versucht nicht, nachträglich mit Überlastung „umzugehen“ - er ist darauf ausgelegt, Verluste zu verhindern und Überlastung verhaltensbasiert über das Fabric zu verwalten.
Cornelis’ CN5000 Director Class Switch-Materialien heben auch feingranulare Telemetrie und Echtzeit-Verkehrsanalysen hervor, um Überlastungen zu erkennen und die Leistung zu optimieren, sowie hochdichte Skalierungspunkte wie bis zu 576 Ports mit 400G in der Director-Class-Plattform.
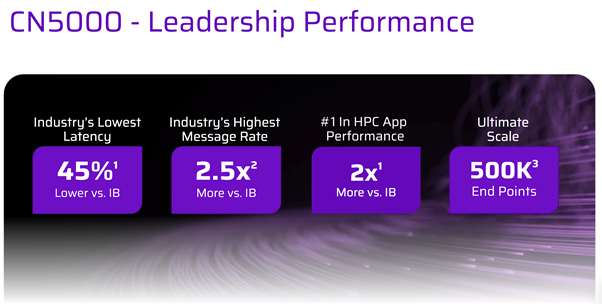
Vergleich: CN5000 Omni-Path vs. gängige Fabric-Ansätze für KI-/Edge-Cluster in der Fabrik
|
Worauf es Ihnen bei intelligenter Fertigung ankommt |
Cornelis CN5000 Omni-Path |
RoCEv2 über Ethernet (verlustfreies Ethernet-Design) |
InfiniBand (typische Bereitstellungen) |
|
Primäres Designziel |
Lossless, congestion-free scale-out network for AI/HPC-style traffic patterns |
RDMA über Ethernet, typischerweise so konstruiert, dass es sich für RDMA-Klassen verlustfrei verhält |
Verlustfreies Fabric-Verhalten mit kreditbasierter Flusskontrolle (gängige Bereitstellungen) |
|
Wie Verlustfreiheit angegangen wird |
Kreditbasierte Flusskontrolle + Überlastungsverhalten auf Fabric-Ebene (Beschreibung von Cornelis) |
Häufig über PFC + ECN/DCQCN (Ende-zu-Ende-Konfiguration und -Abstimmung erforderlich) |
Kreditbasierte Link-Flusskontrolle, um Verluste im Fabric zu vermeiden (typisches Merkmal) |
|
Überlastungsmanagement |
Adaptives Routing + congestion-bewusstes Fabric-Verhalten (Cornelis-Beschreibung) |
ECN/DCQCN-artige Überlastsignalisierung und Ratenanpassung; PFC als Sicherheitsnetz |
Integrierte Fabric-Mechanismen und ausgereifte operative Werkzeuge in vielen HPC-Umgebungen |
|
Betrieblicher Schwerpunkt |
Scale-out-Effizienz + Telemetrie-/Verkehrsanalytik (Cornelis) |
Stark abhängig von einer konsistenten PFC/ECN-Konfiguration über den gesamten Pfad |
Häufig gewählt, wenn deterministisches Fabric-Verhalten priorisiert wird |
|
Warum es am Rande der Fabrik wichtig ist |
Hilft, die Latenz vorhersehbar zu halten, wenn Vision + Analytik + Simulation im selben Pod aufeinandertreffen |
Kann gut funktionieren, aber die Technik für „verlustfreies Ethernet” wird Teil des Projektumfangs |
Eine bekannte Option für verlustfreie Netze mit geringer Latenz (eher typisch in HPC-Umgebungen) |
Der Punkt ist nicht “es gibt nur eine richtige Antwort.” Es ist so, dass intelligente Fertigungs-Edge-Cluster sich wie verkleinerte KI/HPC-Umgebungen verhalten, und CN5000 ist ausdrücklich für diese Verkehrsmuster positioniert - verlustfrei, congestion-managed und in großem Maßstab beobachtbar.
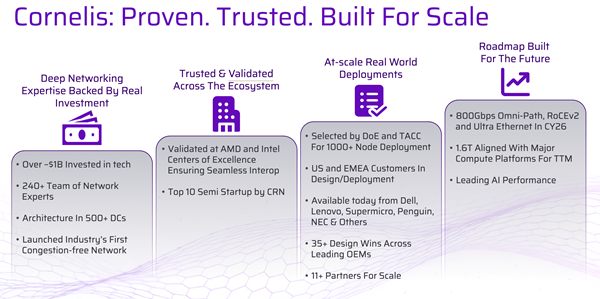
Wo Hammer passt, um ein Fabric in eine einsatzbereite europäische Lösung zu verwandeln
Hersteller kaufen selten “ein Fabric” isoliert. Sie kaufen ein vom Partner geliefertes Ergebnis: ein validiertes Design, integrierte Rack-Aufbauten, Logistik, die zu den Rollout-Zeitfenstern passt, und Supportfähigkeit, die beim ersten Vorfall nicht zusammenbricht.
Hammer positioniert sich genau um diese Art von Enablement, einschließlich interner Rack-Scale-Konfiguration, Tests und Logistik sowie eines beratenden Designansatzes.
Branchenberichte beschreiben auch Hammers Entwicklung zu einer breiteren europäischen Präsenz mit zusätzlichen Büros und Einrichtungen, die schlüsselfertige Rechenzentrumslösungen unterstützen.
In einem Cornelis-Kontext ist Hammers Rolle also die pragmatische: dem Channel zu helfen, CN5000 so zu liefern, dass es der Art entspricht, wie die europäische Fertigung Projekte tendenziell ausrollt - Pilot-Pod → erste Linie → erster Standort → Multi-Standort-Wiederholbarkeit.
Anwendungsfälle, die sich nahtlos in die Funktionspalette der CN5000 einfügen
1) Vision-Inspektions-Pods, die keine Leistungsschwankungen tolerieren können
Hochauflösende Inspektion erzeugt anhaltenden Durchsatz sowie Bursts (Metadaten, Speicherschreibvorgänge, Ereignisauslöser). Verlustfreies, überlastungsgesteuertes Verhalten trägt dazu bei, den Effekt “Es war alles in Ordnung, bis wir zwei weitere Kameras hinzugefügt haben” zu reduzieren.
2) Digital-Twin-Schleifen, die Live-Treue benötigen
Ein Zwillings-Feed wird zu einem Berichtswerkzeug, nicht zu einem operativen Werkzeug. Die Positionierung des CN5000 rund um verlustfreie Übertragung plus Telemetrie/Analytik ist direkt relevant, wenn Sie stabile, beobachtbare Flows am Edge benötigen.
3) Fabrikanalytik im großen Maßstab - ohne die fragile Netzwerkphase
Wenn Sie von einer Linie auf viele skalieren, werden Burst-Druck und Incast-artiges Verhalten häufiger. Wenn Paketverluste zu erneuten Übertragungen und Tail-Latenz führen, leidet die Stabilität. Ein Fabric, das unter Last verlustfrei bleibt, verändert die Skalierungsgeschichte.
Referenzarchitektur: ein “Factory-AI-Pod”, der skaliert
Ein einfaches, wiederholbares Muster, das tendenziell gut funktioniert, ist der Factory-AI-Pod: ein eigenständiger Edge-Cluster, der die Echtzeit-Komponenten lokal ausführt und gleichzeitig für Training und flottenweite Optimierung in die übergeordnete Ebene integriert.
Kernkomponenten
- 4–32 GPU/CPU-Knoten für Inferenz + Analytik
- Lokaler Hochleistungsspeicher (Vision-Puffer, Features, kurze Aufbewahrung)
- Ein dediziertes Scale-out-Fabric für Ost-West-Verkehr (wo der meiste Schmerz liegt)
- Secure north-south connectivity to the plant network and central services
Wo die CN5000 positioniert ist:
- Als Ost-West-Fabric zwischen Compute und Storage, um die Latenz unter gemischter Last vorhersehbar zu halten
- Bereitstellung von Telemetrie und Verkehrsanalysen , um Staus zu erkennen und die Leistung zu optimieren, bevor Bediener Abweichungen bemerken
Wo Hammer hilft:
- Partnergeführte validierte Designs und Rack-Integration, sodass jede Pod-Bereitstellung standortübergreifend wiederholbar ist
Der große Gewinn: Diese Architektur skaliert operativ. Sobald Sie Pod v1 sauber bereitstellen können, können Sie ihn mit weitaus weniger Unbekannten auf andere Werke übertragen.
Leistung mit Telemetrie operationalisieren (weil Fabriken keine Zeit für Rätselraten haben)
Netzwerkprobleme in der Fertigung kommen selten höflich. Sie kommen als:
- intermittierende Inspektionsfehler
- unerklärte Inferenzverzögerungen
- eine Leitung, die nach einem Update “langsamer wirkt”
- Nächtliche Analyse-Jobs, die plötzlich das Wartungsfenster überschreiten
Deshalb ist die Betonung von CN5000 auf feinkörniger Telemetrie und Echtzeit-Verkehrsanalysen mehr als nur ein nettes Feature - es ist ein Wegbereiter für den Betrieb. Cornelis beschreibt ausdrücklich Telemetrie/Analysen, die zur Erkennung von Überlastungen und zur Leistungsoptimierung über große Endpunktzahlen hinweg eingesetzt werden.
In der Praxis unterstützt Telemetrie:
- Schnellere Root-Cause-Isolation (Compute, Storage oder Fabric?)
- Proaktive Optimierung (heiße Links und Muster frühzeitig erkennen)
- Sicherere Skalierung (Kameras/Knoten mit Belegen hinzufügen, nicht mit Hoffnung)
Und da Hammer Partnerbereitstellung und -integration unterstützt, können Sie diese betrieblichen Erwartungen von Anfang an in die Bereitstellung einbauen, anstatt die Beobachtbarkeit erst nach dem ersten Produktionsschreck nachzurüsten.
Abschluss: Behandeln Sie das Netzwerk als erstklassige Architektur
Wenn Sie es ernst meinen mit der Beschleunigung der intelligenten Fertigung in Europa, behandeln Sie das Netzwerk als erstklassigen Teil der Architektur.
Cornelis CN5000 bringt ein Fabric, das für verlustfreie, staufreie Scale-out-Leistung mit adaptivem Routing und tiefer Sichtbarkeit entwickelt und vermarktet wird.
Hammer hilft, diese Fähigkeit über den europäischen Kanal bereitzustellen – wiederholbar, unterstützbar und auf Wachstum ausgelegt.
FAQ: Cornelis CN5000 in der intelligenten Fertigung
Wofür wird der Cornelis CN5000 in der intelligenten Fertigung verwendet?
CN5000 is used as the east–west interconnect inside a factory “AI pod”; the high-speed fabric between compute nodes (GPU/CPU), local storage, and analytics services. In smart manufacturing, that internal traffic is where vision streams, feature extraction, and simulation/analytics collide, and where congestion shows up first as you scale cameras, lines, and pipelines. The goal is predictable latency and throughput under load, not just high peak bandwidth.
Warum verursachen KI-Workloads in Fabriken Netzwerküberlastung und Jitter?
Fabrikdaten sind tendenziell hochratig, burstartig und synchronisiert:
- Mehrere Bildströme können gleichzeitig Inferenz und Speicherung erreichen.
- “Incast”-Momente treten auf, wenn viele Geräte gleichzeitig melden (Alarme, Ereignisse am Zyklusende, Batch-Abschlüsse).
- Sie erhalten anhaltenden Durchsatz plus Mikrobursts, was den Warteschlangendruck erhöht.
Bei Best-Effort-Netzwerken führt das oft zu Warteschlangenbildung, Paketverlusten und erneuten Übertragungen – genau so entstehen Tail-Latency-Spitzen, meist wenn Sie “nur eine” weitere Kamera, Linie oder Pipeline hinzufügen.
Wie unterscheidet sich CN5000 von “verlustfreien Ethernet”-Designs wie RoCEv2?
In vielen RoCEv2-Umgebungen wird das Verhalten von “verlustfreiem Ethernet” durch die Gestaltung des Ethernet-Pfads (üblicherweise mit PFC + ECN/DCQCN) und dessen End-to-End-Abstimmung erreicht.
CN5000 wird typischerweise als ein anderer Ansatz positioniert: kreditbasierte Flusskontrolle und Congestion-Handling auf Fabric-Ebene (plus adaptives Routing), um Verluste und Überlastung nicht eskalieren zu lassen.
Der praktische Unterschied liegt darin, wo die operative Komplexität lebt:
- RoCEv2: mehr in Ethernet-Konfiguration/Tuning-Disziplin
- CN5000: mehr in Fabric-Design + Richtlinien, mit weniger Abhängigkeit von “verlustfreien Ethernet”-Reglern
Wann würde ein Hersteller CN5000 Omni-Path gegenüber InfiniBand wählen?
Beide zielen auf vorhersehbares, jitterarmes Verhalten für Scale-out-Computing ab. Die Entscheidung hängt meist vom Ökosystem und den Betriebsabläufen ab:
- Wählen Sie die Option, die am besten zu Ihrer bestehenden Toolchain, Ihren Fähigkeiten, Ihrem Supportmodell und Ihrer Beschaffungsrealität passt.
- Verwenden Sie eine “Pod”-Perspektive: Wenn Ihr Edge-Cluster wie eine Mini-AI/HPC-Umgebung funktioniert und Ihnen vor allem eine stabile Skalierung unter gemischten Workloads wichtig ist, vergleichen Sie sie anhand realer kollektivintensiver und burstartiger Fabrikmuster, nicht nur anhand sauberer Labor-Benchmarks.
Wie helfen Telemetrie und Verkehrsanalysen beim Betrieb am Fabrikrand?
Probleme in der Fabriknetzwerktechnik treten selten als saubere Alarme auf. Sie zeigen sich als:
- intermittierende Inspektionsfehler
- unerklärte Inferenzverzögerungen
- Analyse-Jobs, die Wartungsfenster überschreiten
Fein granulare Telemetrie hilft Ihnen, schnell zu beantworten: “Compute, Storage oder Fabric?” und heiße Verbindungen, Überlastungsmuster oder Nachbarschaftseffekte zu erkennen bevor Bediener Leistungsabfall spüren. Genau das macht Skalierung sicherer; Sie fügen Kameras/Knoten mit Beweisen hinzu, nicht mit Vermutungen.
Welche Rolle spielt Hammer Distribution bei der Bereitstellung von CN5000 in ganz Europa?
Die Rolle von Hammer besteht in der Regel darin, das Fabric einsatzbereit und wiederholbar zu machen, anstatt es nur zu “kaufen”:
- validierte Designs, die auf die Arbeitslast abgestimmt sind
- integrierte Rack-Builds und Vortests
- Logistik, die an Rollout-Fenster ausgerichtet ist
- Support-Muster für reale Vorfälle (Day-2-Betrieb)
In der Praxis unterstützt dies den üblichen Herstellerweg: Pilot-Pod → erste Linie → erster Standort → Multi-Standort-Wiederholbarkeit.
Was ist ein “Factory-AI-Pod” und wo passt das Netzwerk hinein?
Ein Factory-AI-Pod ist ein wiederholbarer Edge-Cluster, der Echtzeit-Inferenz und Analytik lokal ausführt und gleichzeitig vorgelagert für Training und Flottenoptimierung integriert. Ein typisches Muster umfasst:
- ~4–32 GPU/CPU-Knoten
- local high-performance storage
- ein dediziertes Ost-West-Fabric
Der meiste Skalierungsschmerz liegt in dieser Ost-West-Ebene, daher ist das Fabric das Element, das Sie wählen, um die Latenz unter gemischten, burstartigen Lasten stabil zu halten.
Welche Smart-Manufacturing-Anwendungsfälle profitieren am meisten von einem verlustfreien, staukontrollierten Netzwerk?
Anwendungsfälle, die anhaltenden Durchsatz mit Bursts und Synchronisierung kombinieren:
- Vision-Inspektions-Pods (Streams + Metadaten-Bursts + Speicher-Schreibvorgänge)
- Digital-Twin-Schleifen, bei denen Verspätung “Betrieb” in “Berichterstattung” verwandelt
- Skalierte Analysen über viele Linien (häufige Incast- und Shuffle-ähnliche Muster)
Das gemeinsame Thema: Vermeidung von durch erneute Übertragungen verursachter Tail-Latenz, die die Echtzeitleistung destabilisiert.
Was sind die häufigsten Anzeichen dafür, dass das Netzwerk der Engpass bei Edge-KI ist?
Symptome, die in der Produktion “mysteriös” wirken:
- Intermittierende Inspektionsfehler oder inkonsistente Ausschussraten
- Ungleichmäßige Inferenz-Zeitsteuerung (gleiches Modell, unterschiedliche Latenzzeitpunkte)
- Die Linie “fühlt sich langsamer an” nach Skalierung oder Updates
- Nächtliche/Wartungsfenster-Jobs überschreiten plötzlich das Fenster
Wenn das System stabil war und sich nach dem Hinzufügen der nächsten Kamera/Leitung/Pipeline verschlechtert, ist das Fabric ein häufiger Verdächtiger, besonders wenn das Problem nur unter Spitzenlast auftritt.
Möchten Sie mehr erfahren?