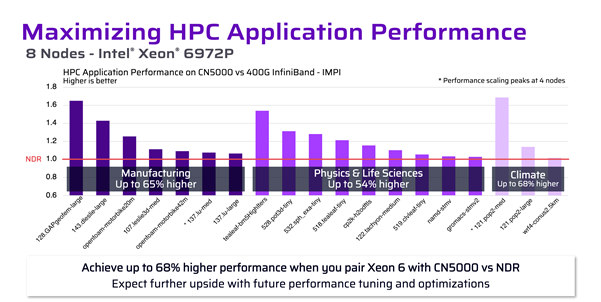
Die Physik- und Biowissenschafts-Communities in Europa drängen in eine neue Ära des Extreme-Scale-Computings: Exascale-Systeme, KI mit Billionen Parametern, datenhungrige Instrumente und Workflows, die Simulation, Analytik und KI in einem einzigen Job kombinieren. Hier ist die harte Wahrheit, die die meisten erst nach einem brutalen ersten Skalierungstest zugeben: Das Netzwerk ist der Engpass, nicht die GPUs, nicht der Speicher, nicht einmal die CPU.
Genau hier greifen Cornelis CN5000 Omni-Path® und Hammers HPC-Lösungsdesign und -bereitstellung ineinander: eine Fabric, die dafür entwickelt wurde, auch unter hoher Last vorhersehbar zu bleiben, gepaart mit einem Ansatz, der europäischen Organisationen hilft, die Architektur zu entwerfen, zu validieren, bereitzustellen und zu unterstützen, die zu ihren Anwendungen passt.
Was sich in der europäischen Forschungstechnik geändert hat und warum das Netzwerk wichtiger ist als je zuvor
Physik und Biowissenschaften treffen auf ähnliche Druckpunkte:
- Großskalige MPI-Kollektive (allreduce/alltoall), empfindlich gegenüber Tail-Latenz
- Viele kleine Nachrichten, bei denen die Nachrichtenrate genauso wichtig ist wie die Bandbreite
- Incast- und Burst-Verkehr (häufig bei KI-Training, Rekonstruktion und Analytics-Shuffles)
- Synchronisationsintensive Simulation, bei der Jitter zu verschwendeter Rechenzeit wird
Wenn ein Interconnect überlastet ist oder Verzögerungen mit langem Schwanz einführt, sehen Sie, wie die Auslastung zusammenbricht – teure Beschleuniger sitzen untätig herum und warten auf den nächsten Batch oder Kollektiv, der abgeschlossen werden muss.
CN5000 in einfachen Worten: Was es ist und wofür es entwickelt wurde
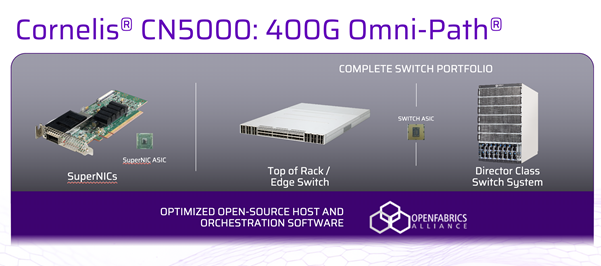
Cornelis CN5000 Omni-Path ist eine skalierbare Netzwerkplattform für KI- und HPC-Umgebungen, in denen hoher Durchsatz und stabile Leistung erforderlich sind, auch wenn das System ausgelastet ist.
Einige praktische Punkte, die für HPC-Teams wichtig sind:
- 400G pro Port Switching (CN5000-Switches werden üblicherweise als 48-Port-400G-Klasse bezeichnet und liefern eine sehr hohe aggregierte Bandbreite pro Switch)
- Sehr hohe Paketverarbeitungskapazität (entscheidend für HPC-Verkehr mit kleinen Nachrichten)
- Ein Designfokus auf die Vermeidung von Leistungsabfällen durch verlustfreies Verhalten, Fabric-Überlastungsmanagement, Multipath-Routing und robuste Flusskontrolle
Die Kernidee: Kommunikation vorhersehbar halten, wenn der Cluster voll mit echten Jobs ist, nicht nur beim Ausführen idealisierter Tests auf einem ruhigen Fabric.
Wo Hammer ansetzt, um die CN5000-Fähigkeiten in eine einsatzbereite europäische Lösung zu verwandeln
CN5000 ist die Fabric-Technologie. Der Wert von Hammer liegt darin, sie in der realen Welt zum Funktionieren zu bringen – Leistungsziele mit Beschaffungsbeschränkungen, Zeitplänen, Standortstandards und betrieblicher Bereitschaft in Einklang zu bringen.
In der Praxis bedeutet das in der Regel:
- Übersetzung von Anwendungsanforderungen (MPI, KI-Training, Pipeline-Analysen) in ein skalierbares Fabric-Design
- -Leistung mit den richtigen Tests validieren (nicht nur mit Standard-Benchmarks des Anbieters)
- Bereitstellung einer integrierten Lösung:
- Switching
- Verkabelung
- Host-Konnektivität
- Konfiguration
- Rollout-Support
- Teams bei der Operationalisierung unterstützen:
- Überwachung
- Änderungskontrolle
- Ersatzteilstrategie
- Supportmuster für den zweiten Tag
Vergleichstabelle: CN5000 vs. gängige HPC/AI-Interconnect-Ansätze
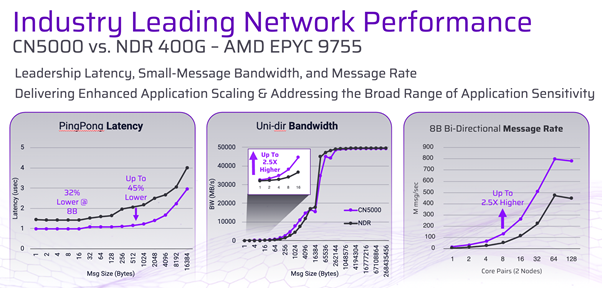
Die “beste” Interconnect-Lösung hängt von Workload, Skalierung und betrieblichen Präferenzen ab. Die folgende Tabelle ist ein praktischer Vergleich auf Architekturebene, den Sie in frühen Design-Diskussionen verwenden können.
|
Kriterium |
Cornelis CN5000 Omni-Path |
InfiniBand (moderne Generationen) |
Ethernet (RoCE / Hochleistungs-Ethernet) |
|
Primäres Designziel |
AI + HPC-Scale-out mit vorhersehbaren Abschlusszeiten unter Last |
HPC/AI-Scale-out, weit verbreitet in High-End-HPC |
Breites Rechenzentrum + KI/HPC, wo Standardangleichung und gemeinsame Werkzeuge entscheidend sind |
|
Verhalten bei Überlastung |
Entwickelt, um die Auswirkungen von Überlastung zu minimieren und die Leistung stabil zu halten (verlustfreies Fabric-Konzept) |
Starke Optionen je nach Konfiguration und Überlaststeuerung |
Kann ausgezeichnet sein, ist aber tendenziell empfindlicher gegenüber korrektem Tuning (PFC/ECN, Pufferung, QoS) |
|
Empfindlichkeit gegenüber Tail-Latenz |
Generell optimiert für niedrige Latenz und Nachrichtenrate |
Im Allgemeinen sehr stark bei geringer Latenz und Kollektiven |
Kann wettbewerbsfähig sein, aber die Tail-Latenz kann sich verschlechtern, wenn falsch konfiguriert oder überbucht |
|
Operative Komplexität |
HPC-fokussierte Tools und Modelle; typischerweise eher “fabric-first” |
Ausgereiftes Ökosystem; starke Betriebsmuster im HPC-Bereich |
Netzwerkteams kennen das, aber “HPC-taugliches RoCE” erfordert in der Regel sorgfältige Design-Disziplin |
|
Ökosystem und Integration |
Für HPC/AI-Stacks entwickelt; Integration hängt von Plattformentscheidungen ab |
Sehr breite Unterstützung des HPC-Ökosystems |
Insgesamt breitestes Ökosystem an Anbietern/Werkzeugen |
|
Typischer optimaler Bereich |
Enge Kollektive, HPC mit hoher Nachrichtenrate, gemischte KI/HPC-Cluster, bei denen Vorhersagbarkeit Priorität hat |
Sehr große HPC/AI-Bereitstellungen mit etablierten IB-Praktiken |
Standorte, die auf Ethernet standardisieren, gemischte Workloads oder ein einheitliches Netzwerkbetriebsmodell anstreben |
|
Häufiges Risiko bei schlechter Wahl |
Zu geringer Umfang der Validierung (reale Workload-Muster nicht frühzeitig testen) |
Kosten-/Verfügbarkeitsplanung; Designentscheidungen sind im großen Maßstab entscheidend |
“Es ist Ethernet, das wird schon gut gehen”-Denken, bis PFC-Stürme, QoS-Lücken oder laute Nachbarn auftreten |
Wenn Sie eine einfache Faustregel wollen: HPC und wissenschaftliche KI brauchen nicht nur schnelle Verbindungen; sie brauchen ein Fabric, das stabil bleibt, wenn alle gleichzeitig kommunizieren.
Ein praktischer Bauplan: Bereitstellung von CN5000 für europäische Physik und Biowissenschaften
1) Beginnen Sie mit dem Kommunikationsprofil (nicht mit der Anzahl der Ports)
Stellen Sie Fragen wie:
- Sind wir kollektiv-dominiert (allreduce/alltoall)?
- Sind wir nachrichtensatzratenbegrenzt (viele kleine Nachrichten)?
- Sehen wir Leistungseinbrüche, wenn das System ausgelastet ist?
- Warten GPUs auf die Synchronisierung?
Dies bestimmt, ob Sie für Bandbreite, Latenz, Tail-Verhalten oder einen ausgewogenen Ansatz optimieren sollten.
2) Planung für Skalierungsstufen, nicht für eine einzelne Momentaufnahme
Viele europäische Organisationen skalieren in Phasen:
- Proof of Value auf Pod- oder Rack-Ebene
- Multi-Rack-Produktion
- Multi-Cluster- oder föderiertes Wachstum
Ein CN5000-Fabric-Design sollte dies von Anfang an widerspiegeln, einschließlich Topologie, Verkabelungsstrategie, Wachstumsports und Betriebsgrenzen.
3) Validierung mit realer Wissenschaft Hören Sie nicht bei Mikro-Benchmarks auf. Beziehen Sie Folgendes ein:
- MPI-Kollektive im vorgesehenen Maßstab
- Mini-Apps und repräsentative Kernel
- KI-Trainingskommunikationstests (kollektiv-intensive Schritte)
- Stresstests mit gemischten Mandanten, wenn Sie gemeinsame Infrastruktur betreiben
Das Ziel ist es, frühzeitig “stille Laborsiege” gegenüber “Siegen in der Produktionsrealität” zu erkennen, solange Änderungen noch kostengünstig sind.4) Frühzeitig operationalisieren (denn am zweiten Tag entscheidet sich, ob Projekte erfolgreich sind oder scheitern)
Planen Sie für:
- Telemetrie und Dashboards (Latenz, Überlastungssignale, Linkfehler, Hotspots)
- Änderungsmanagement (Firmware, Konfigurationsabweichungen, kontrollierte Einführung)
- Ersatzteile und Resilienzplanung
Hier kann Hammers Liefer- und Supportansatz die Lücke zwischen einem schnellen Fabric und einem verwaltbaren Service schließen.
Referenzarchitektur-Muster für europäische Labore und Forschungseinrichtungen
Hier sind drei gängige Muster, die sich beim Aufbau rund um CN5000 für Physik- und Biowissenschaftsumgebungen bewährt haben
Muster A: “Science-Pod” für schnelle Einführung
- 1–2 Racks mit Rechenleistung (CPU oder GPU)
- Dediziertes CN5000-Leaf-Switching
- Klare Ingress-/Egress-Grenzen zu Speicher und dem breiteren Campusnetzwerk
- Ideal zum Nachweis realer Workload-Vorteile und zur Schulung von Betriebsteams
Muster B: Gemischter KI- und HPC-Produktionscluster
- Separate logische Partitionen oder Warteschlangen für:
- KI-Training
- Simulation
- Datenpipelines
- Fabric-Design zur Vermeidung von Auswirkungen durch laute Nachbarn während Spitzentrainingsläufen
- Schwerpunkt auf vorhersehbaren Kollektiven und stabilen Job-Abschlusszeiten
Muster C: Multi-Cluster-Wachstum mit gemeinsamen Diensten
- Mehrere CN5000-gestützte Cluster (z. B. Bildgebung in den Lebenswissenschaften, Physiksimulation)
- Gemeinsame Dienste:
- Authentifizierung
- Planungsrichtlinie
- Überwachung
- Speicher
- Die Fabric-Strategie konzentriert sich auf Wiederholbarkeit: “Wir können dies erneut mit Zuversicht bereitstellen.”
Es gibt kein einziges “richtiges” Design-- es geht darum, dass Sie die Topologie und das Betriebsmodell an die tatsächliche Arbeitsweise Ihrer Organisation anpassen können.
Daten-Governance, Sicherheit und Zusammenarbeit in ganz Europa
Physik und Lebenswissenschaften liegen oft an entgegengesetzten Enden des Daten-Governance-Spektrums – von relativ offenen experimentellen Daten in einigen Physikbereichen bis hin zu hochsensiblen menschlichen Daten in Teilen der Lebenswissenschaften. Modernes HPC-Netzwerkdesign muss diese Realität anerkennen.
Bei der Bereitstellung von CN5000-basierter Infrastruktur in europäischen Umgebungen ist es wichtig, Folgendes einzubauen
- Segmentierung durch Design (Projekte, Mandanten, regulierte Datensätze)
- Prüfbare Änderungskontrolle (wer hat was, wann und warum geändert)
- Klare Grenzen zu Speicher und externen Netzwerken (Überraschungspfade minimieren)
- Bereitschaft zur Zusammenarbeit (Unterstützung für föderierte Zugriffsmodelle, wo angemessen)
Nichts davon ist spektakulär, aber es ist oft der Unterschied zwischen „einem schnellen Cluster“ und „einer Plattform, der die Organisation die nächsten fünf Jahre vertrauen kann“.
Häufige Anwendungsfälle, bei denen CN5000 + Hammer-Lieferung den Unterschied machen können
KI-Training für wissenschaftliche Modelle
- Kollektive, Synchronisationspunkte und Burst-Muster dominieren
- Vorhersagbarkeit unter Last verbessert die Zeit bis zu Ergebnissen
Groß angelegte Simulation mit Synchronisationspunkten
- Tail-Latenz und Jitter können stark gekoppelte Physiksimulationen erheblich beeinträchtigen
- Nachrichtenraten-Fähigkeit und stabiles Verhalten sind wichtig
Bildgebung, Rekonstruktion und Multi-Omics-Pipelines
- Workflows mischen bandbreitenintensive Phasen und kommunikationsintensive Shuffles
- Laufen oft gleichzeitig über mehrere Teams hinweg
FAQ: Wie CN5000 Omni-Path in echten HPC- und KI-Clustern hilft
Wie verbessert Cornelis CN5000 Omni-Path die HPC- und KI-Leistung in realen Clustern?
In Produktionsclustern ist der Durchsatz oft nicht der Engpass, sondern Überlastung und Long-Tail-Latenz. CN5000 wurde entwickelt, um die Kommunikation unter Last vorhersehbar zu halten, sodass Jobs keine „Leistungsabfälle“ erleben, wenn viele Mandanten oder viele Ränge gleichzeitig kommunizieren.
In der Praxis ergibt sich dies aus einem Omni-Path-Design, das Folgendes betont:
- Verlustfreies Verhalten mit kreditbasierter Flusskontrolle (damit Sie unter Druck nicht in Verlust-/Neuübertragungsspiralen geraten).
- Feinkörniges adaptives Routing / Multipath, um vorübergehende Hotspots zu umgehen.
- Aktives Überlastungsmanagement (oft als switch-informiertes Pacing/Verlangsamung beschrieben), um Tail-Effekte zu reduzieren.
Der Nettoeffekt: weniger Stillstände in Kollektiven und Synchronisationsphasen und eine bessere Beschleunigerauslastung, wenn das Fabric ausgelastet ist.
Welche Arten von Workloads profitieren am meisten von CN5000 in Physik und Biowissenschaften?
Der CN5000 zeigt sich am besten, wenn Jitter und Tail-Latenz die Ergebnisse dominieren, insbesondere:
- Enge MPI-Kollektive (z. B. allreduce/alltoall) bei Skalierung
- Anwendungen mit hoher Nachrichtenrate und vielen kleinen Nachrichten
- Synchronisierungsintensive Simulationen, bei denen einige langsame Ränge den Zeitschritt verzögern
- Bursty- oder Incast-lastiger Datenverkehr, der bei Multi-Node-KI-Training, Rekonstruktionspipelines und Shuffle-lastigen Analysen auftritt
Wenn Ihr Profiling bei der Skalierung zunehmend Zeit in Kollektiven, Barrieren oder Halo-Austauschen verbringt, ist dies die Art von Problem, das CN5000 lösen soll.
Warum wird das Netzwerk im großen Maßstab zum Engpass, bevor GPUs oder Speicher es werden?
Wenn Cluster skaliert werden, wird mehr Wandzeit für die Koordination aufgewendet (Gradienten, Reduktionen, Austausche, Barrieren). Wenn Überlastung oder Long-Tail-Verzögerungen auftreten, warten die schnellsten Knoten und GPUs letztendlich auf die langsamsten Kommunikationsereignisse. Die Auslastung kann einbrechen, selbst wenn die “Spitzenbandbreite” auf dem Papier stark aussieht.
Wie unterscheidet sich der CN5000 von InfiniBand oder Hochleistungs-Ethernet (RoCE)?
Auf hoher Ebene:
- CN5000 (Omni-Path): Positioniert als End-to-End-Scale-out-Fabric, das für vorhersehbare Leistung unter Last optimiert ist und verlustfreies Verhalten, adaptives Routing und Überlaststeuerung als erstklassige Designziele nutzt.
- InfiniBand: weit verbreitet in High-End-HPC mit einem tiefen Ökosystem und ausgereiften Betriebspraktiken (hervorragende Leistung, breite Herstellerunterstützung).
- RoCE / Hochleistungs-Ethernet: Betrieblich vertraut und zu starker Leistung fähig, erfordert jedoch in der Regel Disziplin bei PFC/ECN-Design, Pufferung, QoS und Kontrolle lauter Nachbarn, um Tail-Latency-Überraschungen im großen Maßstab zu vermeiden.
Auch klar gesagt: Die “vollen Vorteile” des CN5000 werden typischerweise als Ergebnis einer End-to-End-Omni-Path-Lösung (Switches + NICs) beschrieben, nicht durch Mischen und Kombinieren im Datenpfad.
Was liefert Hammer tatsächlich in einem CN5000-basierten HPC-Projekt?
Hammer turns the interconnect into something you can run day to day, typically covering:
- Anforderungen → Fabric-Design: (Topologie, Oversubscription-Ziele, Wachstumsplan, Verkabelungsstrategie)
- Validierung: Testpläne, die reale Arbeitslasten widerspiegeln (nicht nur ruhige Labor-Mikrobenchmarks)
- Aufbau und Rollout: Switches, Optik/Kabel, Host-Konnektivität, Konfigurationsvorlagen, Cutover-Support
- Betrieb: Monitoring-/Telemetrie-Erwartungen, Änderungsmanagement, Ersatzteilstrategie und Support-Runbooks
Wie sollten wir ein CN5000-Fabric validieren, bevor wir uns für die vollständige Einführung entscheiden?
Eine praktische Validierung vor dem Rollout umfasst in der Regel:
- MPI-Kollektivtests in der vorgesehenen Größenordnung (nicht nur im Einzel-Rack)
- Mini-Apps / repräsentative Kernel aus Ihrer tatsächlichen Nutzerbasis
- KI-Kommunikationstests, die kollektiv-intensive Schritte (und Überlappungsmuster) belasten
- Stresstests mit gemischten Mandanten, um Effekte lauter Nachbarn und Langzeitverhalten aufzudecken
Das Ziel: Fälle zu erfassen, in denen „ruhige Laborerfolge“ nicht auf die Produktion übertragbar sind – solange Topologie- und Richtlinienänderungen noch günstig sind.
Wie entwerfen wir ein CN5000-Netzwerk für schrittweises Wachstum an europäischen Forschungsstandorten?
Viele Programme skalieren in Phasen (Pod → Multi-Rack → Multi-Cluster/Föderation). Häufige Designentscheidungen, die das Wachstum schmerzfrei halten:
- Wählen Sie eine Topologie mit einem klaren Erweiterungspfad (Ports für Wachstum reserviert, vorhersehbare Verkabelung)
- Definieren Sie betriebliche Grenzen frühzeitig (Mandanten/Partitionen/Warteschlangen, QoS-Erwartungen)
- Planen Sie, wie Sie Änderungskontrolle und “Blast-Radius” beim Hinzufügen von Racks oder Standorten handhaben
Auf diese Weise führt Skalierung nicht versehentlich zu neuen Hotspots oder Nachbarschaftsstörungen
Wie können CN5000-Bereitstellungen Datenverwaltung und Sicherheit in ganz Europa unterstützen?
In regulierten Life-Science-Umgebungen ist das Netzwerk Teil der Steuerungsebene für die Governance. Typische Muster sind:
- Segmentierung nach Projekt/Mandant (damit regulierte Datensätze keine Überraschungspfade teilen)
- Prüfbare Konfiguration + Änderungsmanagement, abgestimmt auf Ihr Sicherheitsmodell
- Klare Grenzen zu Speicher und externen Netzwerken, um versehentliche Datenabflusswege zu vermeiden
- Wo Zusammenarbeit erforderlich ist, bewusste föderierte Zugriffsmuster statt Ad-hoc-Peering
Wichtige Erkenntnisse für europäische Forschungsleiter
- Das Netzwerk ist zunehmend der entscheidende Faktor für die tatsächliche Leistung in Physik und Biowissenschaften, insbesondere bei gemischten KI- und HPC-Workloads.
- Cornelis CN5000 zielt auf vorhersehbare Leistung im großen Maßstab ab, wo Überlastungsverhalten und Tail-Latenz oft die Auftragsabschlusszeit dominieren.
- Hammer hilft, diese Fähigkeit in eine funktionierende europäische Lösung umzusetzen:
- Entworfen
- Validierte
- Bereitgestellt
Als Dienst betreibbar – nicht nur eine Sammlung von Hochleistungskomponenten. Kontaktieren Sie noch heute unsere Experten, um Cornelis Networks Solutions zu besprechen
Möchten Sie mehr erfahren?